SOPHGO — это китайская компания, разработчик и производитель специализированных аппаратных решений для искусственного интеллекта. Она создаёт процессоры, ускорители и серверные системы, которые помогают решать сложные задачи ИИ: от компьютерного зрения и видеоаналитики до обучения больших языковых моделей (LLM)
Вот собственно Orange pi выпустили новый одноплатный компьютер на процессоре производства SOPHGO и называется от Orange pi o1.
По характеристикам и тому что установлено в официальном образе от Orange pi:
Orange Pi O1 — SoC Sophgo CV186AH / BM1688:
- 4× Cortex-A73 (aarch64), 16 GiB DRAM
- NPU ~16 TOPS INT8 (
/dev/bm-tpu0, модульsophon_spacc) - Ubuntu 22.04.5 LTS, ядро
5.10.4-sophon-bm1688, Python 3.10.12, pip 22.0.2 - SDK уже в образе:
/opt/sophon— libsophon 0.4.11, sophon-ffmpeg/opencv/gstreamer. Ставить base SDK НЕ нужно.
Куда делись 16 ГБ RAM (это не баг)
Плата у меня на 16GB, но при первом запуске открыв Htop, я увидел, что явно у меня меньше оперативной памяти, чем по факту в ней должно быть.
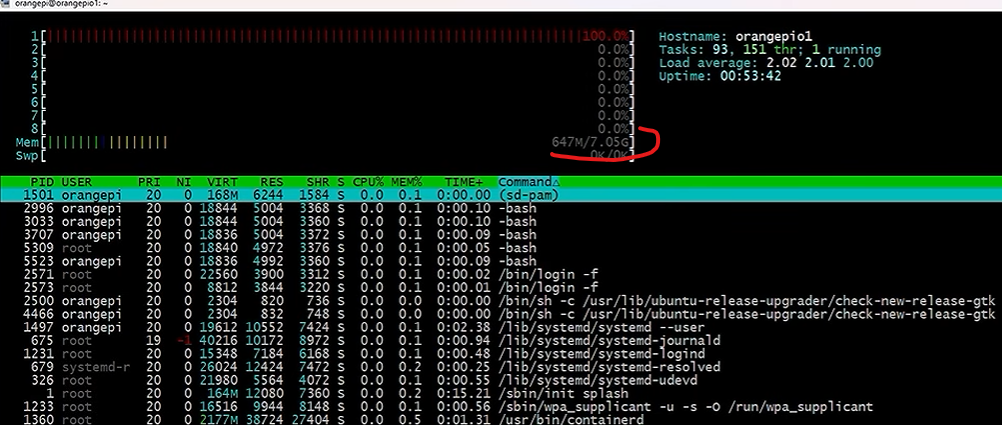
То что показывает Htop это то, что выделено системе, а остальное отдаётся NPU bootloader её вырезает ДО ядра через device tree:
xxd -p /proc/device-tree/memory@100000000/reg        # всего DRAM: 0x400000000 = 16 GiB
for d in /proc/device-tree/reserved-memory/*/; do echo $(basename $d) $(xxd -p $d/reg | tail -c 17); done
ion_npu_mem ≈ 10 GiB — пул NPU, из него живут все bmodel’и. Linux получает остаток. Расширять пул дальше не нужно: три модели влезают (LLM 2.4G + ASR 4.1G + TTS 2.1G ≈ 8.7 GiB).
Следовательно меняя файлы bootloader можно отдавать больше или меньше для npu.
Скачиваем модели Qwen3.5 2B и 4B
Модели уже скомпилированы под NPU BM1688 в формат bmodel — скачиваем готовые у Sophgo через их файловый сервис DFS (нужен интернет на плате):
python3 -m pip install --user dfss
mkdir -p ~/llm/models && cd ~/llm/models

# Qwen3.5-2B int4 (быстрая: ~13 ток/с)
python3 -m dfss --url=open@sophgo.com:/ext_model_information/LLM/LLM-TPU/qwen3.5-2b-int4-autoround_w4bf16_seq2048_bm1688_2core_dynamic_20260415_212627.bmodel

# Qwen3.5-4B int4 (умнее: ~7 ток/с)
python3 -m dfss --url=open@sophgo.com:/ext_model_information/LLM/LLM-TPU/qwen3.5-4b-int4-autoround_w4bf16_seq2048_bm1688_2core_dynamic_20260416_145112.bmodel
Обе модели мультимодальные — внутри есть ViT, то есть они умеют и текст, и распознавание картинок. Файлы выйдут с длинными именами вида qwen3.5-2b-int4-autoround_w4bf16_seq2048_bm1688_2core_dynamic_*.bmodel (2.4 ГБ и 3.8 ГБ). Ещё есть вариант seq8192 с длинной историей диалога — если нужен не зрение, а длинная память чата.
Кроме самих bmodel нужен клон демо-репозитория — в нём скрипты запуска и конфиги токенизатора:
git clone https://github.com/sophgo/LLM-TPU ~/llm/LLM-TPUСборка модуля chat (pybind11)
Движок запуска LLM — это C++ код (chat.cpp), собранный в Python-модуль chat. В репозитории он собирается через CMake, но на этой плате CMake 3.22 ломается на поиске Python (ошибка missing: Development.Module/Development.Embed, даже с установленным python3.10-dev). Поэтому собираем напрямую через g++, это одна команда.
Сначала подсовываем pybind11 туда, где его ждёт демо (apt-версия лежит не там, где ждёт скрипт):
sudo apt install -y pybind11-dev python3.10-dev
ln -sfn /usr/lib/python3/dist-packages/pybind11 ~/.local/lib/python3.10/site-packages/pybind11
Собираем модуль в каталоге демо Qwen3.5:
cd ~/llm/LLM-TPU/models/Qwen3_5/python_demo
g++ -std=c++17 -fPIC -shared -O2 chat.cpp -o chat.cpython-310-aarch64-linux-gnu.so \
  -I/usr/include/python3.10 \
  -I$HOME/.local/lib/python3.10/site-packages/pybind11/include \
  -I/opt/sophon/libsophon-current/include \
  -L/opt/sophon/libsophon-current/lib -lbmrt -lbmlib
Проверка, что модуль собрался и видит NPU-библиотеки:
python3 -c "import chat; print('ok')"Ставим Python-зависимости демо (pip на плате старый, PEP 668 не мешает — обычный --user работает):
python3 -m pip install --user "Pillow>=10" qwen-vl-utils
python3 -m pip install --user torch torchvision --index-url https://download.pytorch.org/whl/cpuPillow>=10— системная версия 9.x старая, безPIL.Image.Resampling, на ней запуск падаетtorch/torchvision— CPU-сборки для aarch64, GPU на плате нет, вся тяжёлая работа на NPU
Распознаём картинку: команды
Интерактивный режим (модель грузится один раз, дальше можно задавать много вопросов). Картинка прикрепляется к вопросу символом @ и путём:
cd ~/llm/LLM-TPU/models/Qwen3_5
python3 python_demo/pipeline.py \
  --model_path ~/llm/models/qwen3.5-2b-int4-autoround_w4bf16_seq2048_bm1688_2core_dynamic_20260415_212627.bmodel \
  --config_path ./config --devid 0
Внутри чата (модель грузится ~15 секунд):
Что на картинке @/home/orangepi/photo.jpg ?
/exit # выход
Вот на картинке мой вопрос и ответ:
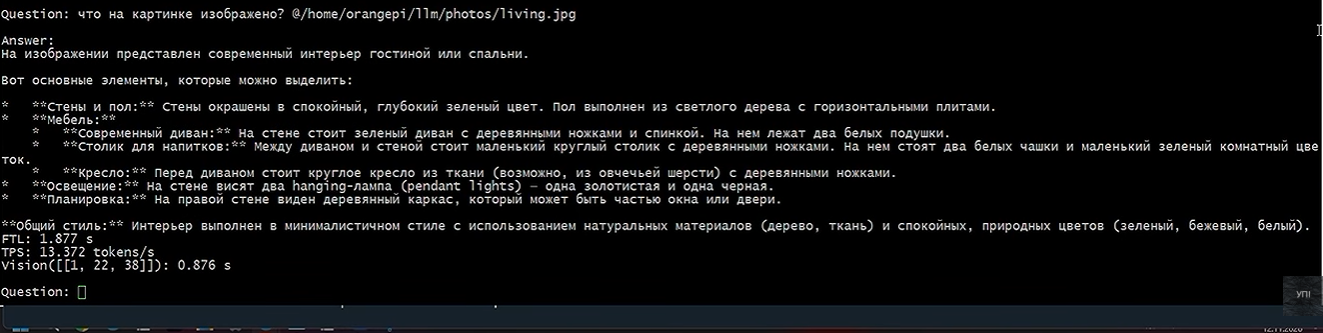
Картинка была такая:
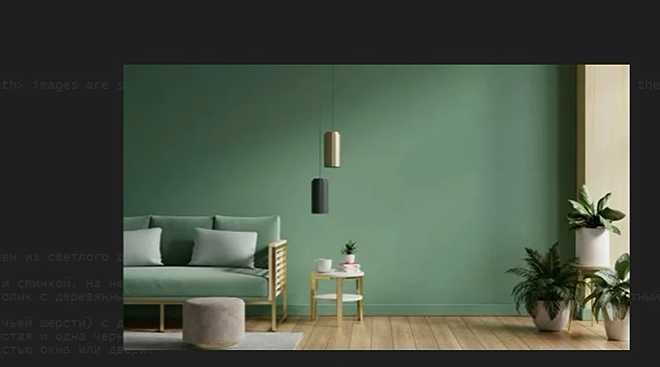
Первый вопрос по картинке дольше (ViT обрабатывает изображение ~1-3 с + предзаполнение), дальше ответы идут быстро. Для 4B модели та же команда, только --model_path на её файл.
Одним запросом без интерактива (модель каждый раз грузится заново — удобно для скриптов, но медленнее):
cd ~/llm/LLM-TPU/models/Qwen3_5
python3 python_demo/pipeline.py \
  --model_path ~/llm/models/qwen3.5-2b-int4-autoround_w4bf16_seq2048_bm1688_2core_dynamic_20260415_212627.bmodel \
  --config_path ./config --devid 0 \
  -p "Что на картинке @/home/orangepi/photo.jpg ?"
Скрипт: смотрим в RTSP-камеру и описываем что там
Практический кейс: плата берёт кадр из RTSP-потока камеры и описывает словами, что происходит — люди, машины, движение. Модель грузится один раз и висит в памяти, кадры обрабатываются в цикле.
Один важный нюанс: ffmpeg из софтовского SDK по умолчанию берёт аппаратный декодер h264_bm, который на RTSP падает с «Generic error in an external library». Лечится ключом -c:v h264 (мягкий декодер) — он должен стоять ДО -i.
Скрипт ~/rtsp_watch.py целиком:
#!/usr/bin/env python3
"""RTSP camera frame describer on Qwen3.5 vision bmodel (BM1688 NPU).

Deploy to ~/rtsp_watch.py on the Orange Pi O1 (.43).
Usage: python3 rtsp_watch.py [--interval 30] [--once] [--prompt "..."]
Model loads once; loop: grab frame via ffmpeg -> describe.
"""
import argparse
import os
import subprocess
import sys
import time

sys.path.insert(0, os.path.expanduser("~/llm/LLM-TPU/models/Qwen3_5/python_demo"))
os.chdir(os.path.expanduser("~/llm/LLM-TPU/models/Qwen3_5/python_demo"))

RTSP = "rtsp://192.168.31.104:8554/Fasad3"
FFMPEG = "/opt/sophon/sophon-ffmpeg-latest/bin/ffmpeg"
FRAME = "/tmp/rtsp_frame.jpg"
MODEL = os.path.expanduser("~/llm/models/qwen3.5-2b-int4-autoround_w4bf16_seq2048_bm1688_2core_dynamic_20260415_212627.bmodel")
CONFIG = os.path.expanduser("~/llm/LLM-TPU/models/Qwen3_5/config")
PROMPT = "Что сейчас на этом кадре с камеры наблюдения? Опиши кратко и по делу на русском: люди, машины, движение, необычное."


def grab_frame():
    # -c:v h264 BEFORE -i forces the native soft decoder; sophon ffmpeg's
    # default h264_bm HW decoder fails on RTSP with "Generic error in an
    # external library".
    r = subprocess.run(
        [FFMPEG, "-c:v", "h264", "-rtsp_transport", "tcp", "-i", RTSP,
         "-frames:v", "1", "-q:v", "3", "-y", FRAME],
        capture_output=True, timeout=25)
    return r.returncode == 0 and os.path.exists(FRAME) and os.path.getsize(FRAME) > 1000


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--interval", type=float, default=30, help="seconds between frames")
    ap.add_argument("--once", action="store_true", help="single frame and exit")
    ap.add_argument("--prompt", default=PROMPT)
    args = ap.parse_args()

    import pipeline  # local demo module (imports chat.so)

    class A:
        devid = 0
        model_path = MODEL
        config_path = CONFIG
        video_ratio = 0.25

    print("Loading model on NPU...")
    model = pipeline.Qwen3_5(A())
    print("Model ready.\n")

    while True:
        t0 = time.time()
        if not grab_frame():
            print(f"[{time.strftime('%H:%M:%S')}] Failed to grab frame from {RTSP}")
        else:
            print(f"\n===== {time.strftime('%H:%M:%S')} =====")
            text = model.run_once(args.prompt, [FRAME])
            if text is None:
                print("(empty answer)")
        if args.once:
            break
        time.sleep(max(0, args.interval - (time.time() - t0)))


if __name__ == "__main__":
    main()
Запуск:
python3 ~/rtsp_watch.py --once                # один кадр и выход
python3 ~/rtsp_watch.py --interval 30         # кадр каждые 30 секунд
python3 ~/rtsp_watch.py --prompt "Есть ли во дворе люди?"- В начале скрипта задаются
RTSP(ссылка камеры),MODEL(какой bmodel — 2B или 4B) иPROMPT(что спрашивать про кадр) - Скорость: 2B описывает кадр примерно за 5-8 секунд (ViT + генерация), 4B медленнее
- Кадр сохраняется в
/tmp/rtsp_frame.jpg— можно проверять, что реально увидела модель